 |
 |
|
|
| 第一屆中國文字學會學術討論會•天津 1996年8月25-30日 電子古籍中的缺字問題 |
| Page 5 of 8 |
| 參、系統設計與實務
前文談到問題的;背景和一些觀念、理論,在此報告解決缺字問題的實踐。我們將構字模式、校勘過的《交大字根系統》及《中文電腦基本用字》放在電腦中構成「字形資料庫」,希望以此為基礎發展。【註七】 談電腦的實踐,免不了涉及些較專門的工程技術,但本文重點不在此,故仍以字形相關的實務為此報告的重點。
一、系統概述
本系統是在IBM相容的個人電腦中,台灣版中文視窗3.1作業作業系統下,用Visual Basic程式語言發展。系統中有兩個資料庫,《字形資料庫》及《文字屬性資料庫》,都是用Foxpro資料庫管理系統建立的。 這個系統有幾個用法。當系統內尚無資料,或是要分析一套尚未載入系統的字形時,可以逐字將字形的結構資料,包括文字、字形、部件或字根、基本筆劃等。以人機互動的方式,建立電腦內部的結構。此時,若有文字或字形的字頻統計,亦可一併載入留待後用。一套字形載入後,即可對這套文字作各種查詢,包括每一個字形的構成、字根孳乳表、文字孳乳表、以及字形、字根、部件等的統計資料。其次,若有某字形的構字待比較,則可叫出計算機內既有的字形由人比對,或將該字的結構輸入由計算機比對。若是有兩套字形均已載入計算機中,則計算機可以詳列此兩套字形的差異。可載入計算機中字形的套數不限。蒐集越多,則越具參考價值。 目前系統已經輸入了三個字集,其一是校勘後的《中文電腦基本用字研究》,共收 8529 個字,另有參照字形 593個,部件629個,字根457個。其二為前述字集再加上大陸的標準簡化字【註八】,字數不變,參照字形增加為2284個,部件664個,字根492個。第三個字集為《電子佛典補字集》,只收錄一些機構製作電子佛典時所缺的字,目前有500餘字,字數尚在增加中。 系統中的文字、字形、部件、字根、筆劃之呈現方式如下:
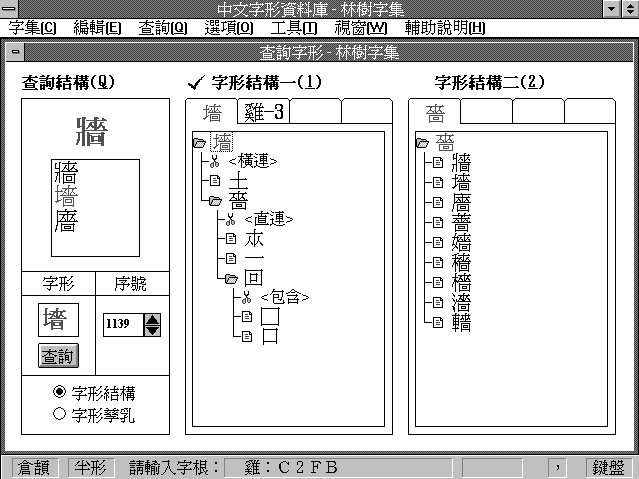
依本系統的設計,可以由構字上觀察到字形,由標示中觀察到筆劃的變化;卻看不到實際的「字樣」。目前,系統只完成〔圖四〕中的字形結構部份,至於由筆劃組成字根的部份則尚未完成。 字形資料庫的檢索歸納為字形查詢與頻次查詢兩個介面。字形查詢時可查字形結構和字形孳乳,但請先注意字與字形的區分。例如查詢林樹字集中的「�晼v字時,視窗畫面上會看到「牆」、「�晼v及「廧」三個字形, 以「牆」為該字集的標準字。其次,並非所有的字形皆可看到實際的「字樣」,原則上,我們並不為這些字造形,而是以構字式表示。例如:查詢「雞」時,可看到「雞」、「雞-3」及「雞-4」三個字形;其中字形「雞-3」為「奚」橫連「鳥」,「雞-4」則為「又」橫連「鳥」。字形查詢的畫面如〔圖七〕,以下簡單列出查詢的方法及注意事項。
圖七、字形的查詢
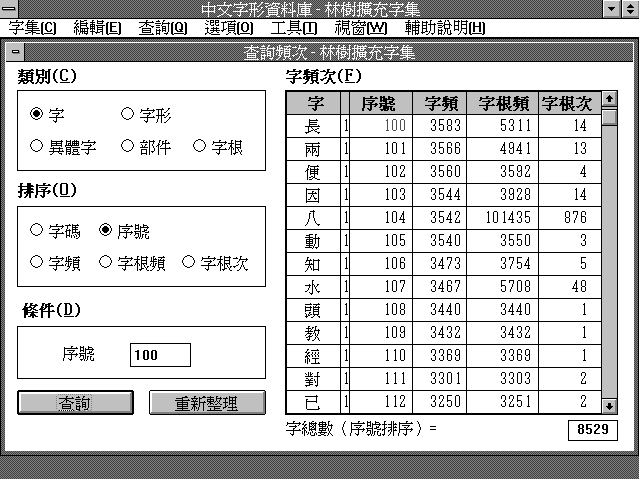
頻次查詢時,應先示明所選之字集、查詢之對象及排序方式。查詢的對象有字、字形、異體字、部件及字根等,排序則可依字碼、序號、字頻、字根頻、字根次等排列。至於字根頻及字根次的意義可以林樹字集中的字形「故」、「做」為例說明:
(二)字形的表達與呈現 讓我們先用例子,來說明一些名詞和符號,以及構字信息在電腦中的表達方式。〔圖六〕最右一枝中的一些字在電腦中的表達如下: 1. 灕=���臕驉@2. 離=离��隹 3. 璃=王��离 4. 擒=���繨V 5. 噙=口��禽 6. 离=�^��禸 7. 禽=�]�鵖獺@8. 隹=�����翩@9.�翩��B���w�g 10.�^=�B�韙縑@11. 凶=凵���I�t��1至11這些式子稱為「構字式」,其中�����韝嬪O表示橫連、直連、包含等定位符號。電腦可依構字式,逐次追蹤以消去式中的字或部件,而得到完全以字根表示該字構成的「字根構字式」。如(3) : 灕=����(离��隹) =���礡](�^�鮸芋^�礡]�����翩^) =���礡]((�B�韙縑^�鮸芋^�礡]���礡]�B���w))) =���礡]((�B�鞢]凵���I))�鮸芋^�礡]���礡]�B���w)))…… (3) (3)式中的「灕」是八個字根構成的,若省去定位符號,(3)式可寫為: 灕=���B�I凵禸���B�w …… (4) (4)式稱為灕的「字根序」。比照此法,1至11式也可將定位符號省略,省略後的式子稱「部件序」,或「字根序」。 構字式中擁有字形結構完整的資料,部件序和字根序則否。雖然如此,字根序的判別能力還是很強的,在林樹字集中,只有八對字沒法以字根序判別,如(唄、員)。是故在判別字時,用字根序不失為一良法,它比構字式單純得多。可是,在實用上它還是嫌太長。部件序雖然所含的字形信息最少,但是它最簡潔:通常只有二個部件(偶有三個),而且省略的一個定位符號絕大部份可由前後部件的性質中判斷出來(用電腦)。所以,用它來表示所缺的字是很方便的。 我們可以把一個字集中所有字形的構字式放在字形資料庫裡,這樣便完整地將該字集的字形信息(或知識)放入了電腦。以《中文電腦基本用字》為例,共有9756個構字式,其中8529個屬字集的,593個屬異體字,629個屬部件的。若將該字集中對映的簡化字也放進去,則有2284個屬異體字的構字式,部件加多了35個共計664個,而8529個屬字集的依舊不變,總計11477個構字式。 (三)字形變化的標示 用SGML來標示缺字的方法,是由Wittern及App首先提出的【註一】,稱為「漢字位標」(Kanji Placeholder,簡稱位標)。漢字位標規定以「&」起頭,以「;」結束,而夾在其中的字串分為兩個部份,分別表示該字形在某一碼的某一位置。 利用此位標,就可以跨不同的碼來互補缺字。Wittern及APP建構了一漢字庫(KanjiBase),包括JIS,BIG5(即五大碼),Unicode及CNS等。其中CNS有4萬八千字,字數最多,Unicode次之。若平時作業中遇有缺字,則首先在CNS中查尋,如果有該字字形,則用位標將CNS之碼標明在文件中;若無,再Unicode。例如:「&U4AB5」表示一缺字;其中U表示Unicode字集,4AB5表示該缺字字形的Unicode碼位。 這個方法可以減少缺字,是有用的;而且它採用了國際的標準作為換碼的控制,有助於大家採用流通。然而,依前言中的討論,這個方法並沒有完全解決缺字所帶來的諸多困擾。再者,由於「&」被用為控制碼,雙語文章中若要用「&」時怎麼辦呢?善用SGML是解決缺字問題有力的方法,本系統將修正漢字位標的作法,提出更有效的方案。 漢字位標是以SGML的標示(tag)為載具,用其他字碼中的字形來表達缺字。仿此,我們可用構字信息,即構字式、字根序或部件序來表達缺字,稱為漢字形標(Kanji Glyphholder),簡稱形標。以部件序為例,說明如下。 假設��表示標示的起點(open delimiter),��表示結束(close delimiter),則佛經中的阿門佛可用:阿��門人人人��佛的字根序表示;如果字集中有「�鬗H」字,也可用阿��門�鬗H��佛的部件序表示。這樣的表達方式,可以免去查其他字碼的工作,而部件式所含的信息足夠作為認別該字缺字之用。 同樣的方法也可用來標示異體字。所用的方法是在構字式(或字根序、部件序)之後用一「•」作區隔,再接上該字的字形碼。所用的標示與上相同。如,「芍��藥•3��」表示「芍葯」,若葯是藥的第三個異體字。 形標並不排除位標,Wittern和App的漢字位標也可以放在��和��之間的。所以,形標包含位標的功能,比位標更方便,是位標的延申。 (四)兩岸字形的共享 為了兩岸字形能夠互通共享,我們嚐試將簡化字及大陸的字根與「部件」納入系統中。在簡化字方面,是採用蘇培成根據1986年《簡化字總表》所編的《漢字繁簡對照字典》中收錄簡化字。目前已填入與《中文電腦基本用字》中能相互對應的2017個,餘下未收的242字正在造字樣,尚未填入【註十】。至於字根方面,則採用武漢大學《現代漢語定量分析》書中收錄傅永和先生〈漢字結構及其構成成分的統計及分析〉一文中所列的字根,以及ISO/IEC JTC1/SC2/WG2/JRG N319號文件〈ISO 10646 Additional Components 〉的字根。這些字根並未一次放入系統中,目的是要測試二者的相容程度。結果顯示兩岸的字根是十分相容;加了2235個字形後只增加了35個字根和36個部件,其中多屬簡化的偏旁及部件。 在字形結構方面,遇到了一個問題,那就是簡化後的偏旁或部件有使用情境的限制,如「�\」不單獨使用,亦不出現在字形的下方。又如,蘭簡化為 ,攔簡化為 ,讕卻簡化為 ,不是 。闌是簡化為 的,是不是字典錯了,攔應簡化為 ?因為蘭不是闌呀。由於文獻不夠,我們很難查證,也無法獲得簡化字時所定的規則加以判斷。這種依情境而作不同簡化的情況,使得在孳乳結構中產生了些例外。也引發了界定「界體字根」的課題,換言之,沒有辦法簡單地用一字根替代另一字根而得到繁簡的對映,只有逐字登記其構字。我們相信簡化必有依據與規則,若可獲得這些規則或將之納入電腦,以便更有系統地表達簡化字形。由於有這種情形,也使得有些可以「類推」的簡化部件,在類推時產生猶豫,如婁簡化為米�韙k,嶁、寠、廔等三字在字典中找不到,是不是可類推呢?或是這些字已刪除了? 其次,據聞大陸整理過異體字表,在簡化過程中合併了些異體字,如鉋、碼�禰獢B砲、炮合併成炮。這情形也因為我們缺乏了解而產生問題:究竟鉋、碼�禰獢B砲、砲還在不在GB字集中?它們是消失了?或是仍算作異體字?如果能獲得異體字表及相關信息,我們就不會如此無知而不知該怎樣處理這些字。 此外,在筆劃方面也有些差異,如:「�驉v與「�f」,「呂」與「�穭f」等。這些差異用分毫字樣的函數盡可表達,應該不會造成問題。只是《漢字繁簡對照字典》中找不到�k字,雖然在鋁、閭兩字中可以印證,但總是不放心。也許是我們用的《漢字繁簡對照字典》不太好罷,在資料收集上我們應更努力。 總之,繁簡字形合併在字形資料庫中,目前雖有些問題,但大體上是可行的、成功的。前述的困難加大了字形結構上的複雜程度,並不是不能實踐。 【註一】 Christian Wittern and Urs App.〈IRIZ Kanji Base : A New Strategy for Dealing with Missing Chinese Characters 〉 世界電子佛典會議(EBTI)台北,1996年4月 【註七】 謝清俊、莊德明、張翠玲、許婉蓉,〈中文字形資料庫的設計與運用〉,中國文字學會年會,台中1995 【註八】
依照《簡化字總表》(1986年版),共取簡化字2235個,及相對應的繁體字2259個。 【註九】詳見許婉蓉,〈林樹字集的更正及問題字〉,中研院資訊所文獻處理實驗室,1996 【註十】許婉蓉,《林樹擴充字集中的簡化字》,文獻處理實驗室,中矸院資訊所,1996 |
||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Page 5 of 8 |
|